LLM-Training in Zahlen: 100.000 Grafikkarten, 50 Billionen Token
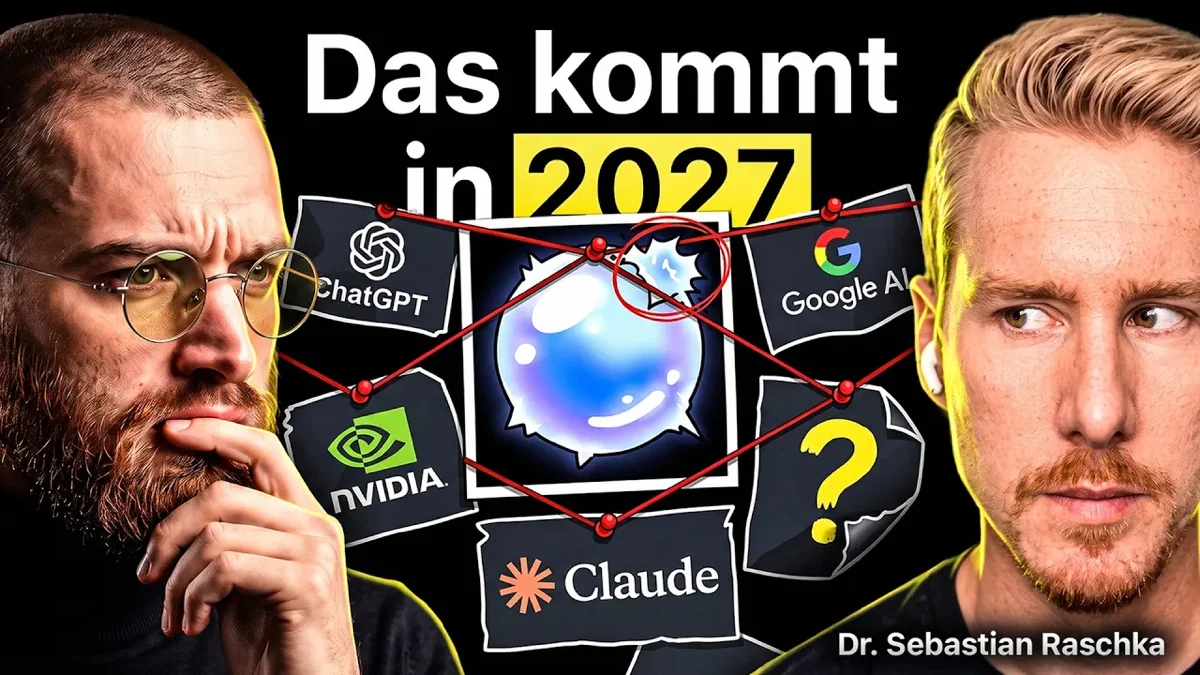
LLM-Training ist der mehrstufige Prozess, der aus Rohdaten nutzbare Sprachmodelle macht. Dr. Sebastian Raschka erforscht diesen Prozess seit über zehn Jahren in den USA. Im ersten deutschsprachigen Interview mit Leonard Schmedding ordnet er den Stand 2026 ein. Sein Fazit: der größte Hebel liegt heute im Post-Training.
Raschka stammt aus Herne und studierte Biologie in Düsseldorf. Nach der Promotion in Computational Biology folgte eine Tenure-Track-Professur für Statistik in Wisconsin. Diese gab er für ein Startup auf und arbeitet heute unabhängig. Als Referenz gelten seine Bücher Build a Large Language Model (From Scratch) und Build a Reasoning Model (From Scratch). Über 210.000 Leser abonnieren seinen Newsletter. Im Gespräch mit Everlast AI erklärt er die Technik hinter den Modellen des Alltags.
Pretraining: sammeln, filtern, synthetisch ergänzen
Die Basis jedes Modells bleibt das Pretraining. Das Modell sagt dabei Token für Token das nächste Wort vorher. Die Methode stammt aus dem klassischen Deep Learning. Schwierig ist die Skalierung. Für ein Modell der GPT-6-Klasse laufen rund 100.000 Grafikkarten parallel.
Der Datenhunger ist stark gewachsen. Vor drei bis vier Jahren reichte etwa eine Billion Token. Heute trainieren die Labs auf 30 bis 50 Billionen Token. Ein Token entspricht grob ein bis zwei Wörtern. Rohe Masse allein genügt aber nicht mehr.
Gefiltert wird härter als früher. Dazu kommen synthetische Daten aus anderen Modellen. Raschka vergleicht das mit einem Mathematik-Buch statt eines Forenarchivs. Geordnete Inhalte führen schneller zum Lernerfolg. Qualität schlägt Rohmenge, sobald die Datenmenge saturiert.
Post-Training: Reasoning entsteht durch Belohnung
Nach dem Pretraining folgen drei Stufen. Zuerst schärft Supervised Fine-Tuning das Befolgen von Anweisungen. Danach richtet Preference Tuning den Stil an menschlichen Vorlieben aus. Ein Beispiel aus dem Interview: technische Antwort zum RAM oder allgemeine Antwort zur Akkulaufzeit. Beide Antworten stimmen, die Vorlieben unterscheiden sich.
Die dritte Stufe prägt die heutigen Modelle am stärksten. Reinforcement Learning with Verifiable Rewards belohnt nur korrekte End-Ergebnisse. Bei Mathe- und Code-Aufgaben lässt sich das Ergebnis prüfen. Das Modell lernt über Versuch und Irrtum die Schritte dazwischen. Genau diese Schritte heißen heute Reasoning.
Raschka hält den Ansatz für robuster als oft angenommen. In eigenen Experimenten griff er schon bei 0,6 Milliarden Parametern. Das ist rund 100 mal kleiner als DeepSeek-R1. Der Branche fehlte lange der Mut zum teuren Basismodell.
Computer Use: warum OpenAI Mac Minis in Rechenzentren stellt
Den größten Sprung erwartet Raschka bei der Computer-Nutzung. Modelle sollen Software bedienen statt nur Text zu liefern. Dafür fehlen Beispiele aus echten Abläufen. OpenAI kaufte deshalb rund zehntausend Mac Minis und Mac Studios. Trainiert wird weiter auf Nvidia-Karten.
Die Macs liefern Daten, keine Rechen-Leistung. Screenshots, Klickpfade und Multi-Step-Abläufe werden zum Rohstoff. Noch begehrter sind interne Prozessdaten. Die internen Daten der insolventen Spirit Airlines gingen für Millionen an einen Tech-Konzern.
Finanzhäuser halten ihre Prozessdaten dagegen zurück. Genau dort liegt ihr Differenzierungs-Faktor. OpenAI umgeht das Problem im Projekt Mercury. Hunderte frühere Investment-Banker beschreiben dort Finanz-Modelle für 150 Dollar pro Stunde. Für Unternehmen zeigt das den Wert der eigenen Ablage.
Looped Transformer: was hinter GPT-6 Astra steckt
Ein Gerücht aus dem Branchen-Dienst The Information beschäftigt die Szene. GPT-6 Astra soll auf einem Looped Transformer basieren. Die Architektur bleibt im Kern ein Transformer. Statt 44 eigener Blöcke laufen die Daten zweimal durch 22 Blöcke. Ein Router entscheidet, welche Token mehrere Runden brauchen.
Der Trick spart Parameter, keine Rechenzeit. Eine offene Architektur aus China hat die Wiederholung bereits getestet. Zweimal lohnt sich, dreimal kostet mehr und bringt weniger. Raschka nennt das einen Kompromiss, keinen Durchbruch. Details zum Modell stehen in unserer Analyse zu GPT-6 Astra.
Auch die versteckten Reasoning-Traces erklärt er nüchtern. Stärkere Modelle brauchen weniger Token bis zur Lösung. Bei GPT-5.6 zeigt sich das an den Größen-Klassen Luna, Terra und Soul. Luna schreibt mehr Denk-Schritte als Soul und bleibt trotzdem günstiger.
Open-Weight-Modelle aus China und Europas eigenes LLM-Training
Benchmarks zeigen chinesische Modelle fast auf Augenhöhe. Im Alltag sieht Raschka den Abstand größer. Der Grund liegt im Harness, nicht im Modell. Codex und Claude Code sind auf ihr jeweiliges Modell feinjustiert. Bei Computer Use liegen die Open-Weight-Modelle noch zurück.
Uneinholbar ist dieser Vorsprung nicht. Die Lücke lässt sich in Monaten schließen, nicht in Jahren. Wie strategisch China dabei vorgeht, zeigt unsere Einordnung zu Chinas KI-Strategie.
Spannend wird das Gedanken-Experiment aus dem Interview. Mit 100 Millionen Euro Fördergeld würde Raschka kein Pretraining starten. Das Geld ginge komplett ins Post-Training auf einem offenen Basismodell. Parallel dazu empfiehlt er ein zweites Team für Pretraining-Erfahrung. Ein eigener Frontier-Lauf kostet realistisch Hunderte Millionen Dollar.
Prognosen für 2027: Computer Use, Subagenten, Effizienz
Einen Architektur-Bruch erwartet Raschka nicht. Diffusions-Modelle bleiben vorerst eine Nische. Arbeit Schritt für Schritt passt besser zu Tool-Aufrufen. Stattdessen läuft die Optimierung weiter Richtung Effizienz. Sparse Attention und Multi-Head Latent Attention wirken schon heute wie ein Frankenstein-Bau.
Beim Tempo setzt er auf Subagenten. Mehrere Helfer-Modelle arbeiten parallel an Teilaufgaben. Bis zu zehnfache Token-Geschwindigkeit hält er für erreichbar. Größere Kontext-Fenster erwartet er dagegen kaum. Eine Million Token bleibt der Standard, gesteuert über ausgelagerte Textdateien.
Das größte Bottleneck sieht er an anderer Stelle. Modelle passen bis heute nicht zum einzelnen Nutzer. Continual Learning löst das kurzfristig nicht, weil Rechen-Leistung knapp bleibt. Freies Lernen verschwendet Ressourcen und kann Qualität kosten. Gezieltes Sammeln und Trainieren bleibt effizienter.
Fazit: LLM-Training verschiebt sich ins Post-Training
Das LLM-Training hat seinen Schwerpunkt verlagert. Pretraining liefert die Basis und saturiert langsam. Den Unterschied machen Post-Training, Harness und Computer Use. Für Unternehmen heißt das: der Hebel liegt in Werkzeugen und Prozessdaten. Mehr Rohdaten bringen dagegen wenig.
Raschkas Rat bleibt schlicht. Wer die Grundlagen der Transformer-Architektur versteht, trennt Hype schneller von Substanz. Ein Artikel reicht dann statt zehn. Wer diese Basis strukturiert aufbauen will, findet passende Kurse auf kilernen.de.
Häufige Fragen
Wie funktioniert LLM-Training heute?
LLM-Training läuft in zwei großen Phasen. Im Pretraining sagt das Modell Token für Token das nächste Wort vorher. Dafür dienen heute 30 bis 50 Billionen Token. Danach folgt das Post-Training aus Supervised Fine-Tuning, Preference Tuning und Reinforcement Learning mit prüfbaren Belohnungen. Dr. Sebastian Raschka sieht den größten Fortschritt inzwischen in dieser zweiten Phase. Dort entstehen Reasoning und die Fähigkeit, Werkzeuge und Software zu bedienen.
Was ist der Unterschied zwischen Pretraining und Post-Training?
Pretraining baut das allgemeine Sprachwissen auf. Das Modell lernt aus Text, Code, Büchern und Bildern, ohne Bezug zur Aufgabe. Post-Training formt daraus einen nutzbaren Assistenten. Dazu gehören das Befolgen von Anweisungen, der gewünschte Stil und das Reasoning über Belohnungen. Auch Computer Use entsteht im Post-Training. Laut Raschka saturiert das Pretraining langsam, während im Post-Training noch große Sprünge möglich sind.
Was bedeutet Computer Use bei KI-Modellen?
Computer Use beschreibt Modelle, die einen Rechner selbst bedienen. Solche Modelle sehen Screenshots, klicken, tippen und arbeiten mehrere Schritte ab. Dafür brauchen die Labs Beispiel-Daten aus echten Abläufen. OpenAI stellte dafür rund zehntausend Mac Minis und Mac Studios in Rechenzentren. Raschka hält Computer Use für das prägende Thema 2027. Erstmals erreicht KI damit Berufe außerhalb der IT.
Wie groß ist der Abstand zu chinesischen Open-Weight-Modellen?
In fairen Benchmarks liegen die Modelle nah beieinander. Im Alltag fällt der Abstand größer aus. Der Grund ist der Harness, also die Umgebung um das Modell herum. Codex und Claude Code sind auf ihr jeweiliges Modell feinjustiert. Bei Computer Use hinken die Open-Weight-Modelle noch hinterher. Uneinholbar ist der Rückstand nach Raschkas Einschätzung nicht, er lässt sich in Monaten aufholen.
Was ist ein Looped Transformer?
Ein Looped Transformer schickt Daten mehrfach durch dieselben Blöcke. Statt 44 eigener Blöcke mit eigenen Gewichten nutzt das Modell 22 Blöcke zweimal. Das spart Speicher für Parameter, kostet aber die gleiche Rechenzeit. Ein Router kann entscheiden, welche Token mehrere Runden durchlaufen. Gerüchte verbinden die Architektur mit GPT-6 Astra. Raschka wertet sie als sinnvollen Kompromiss, nicht als technischen Durchbruch.