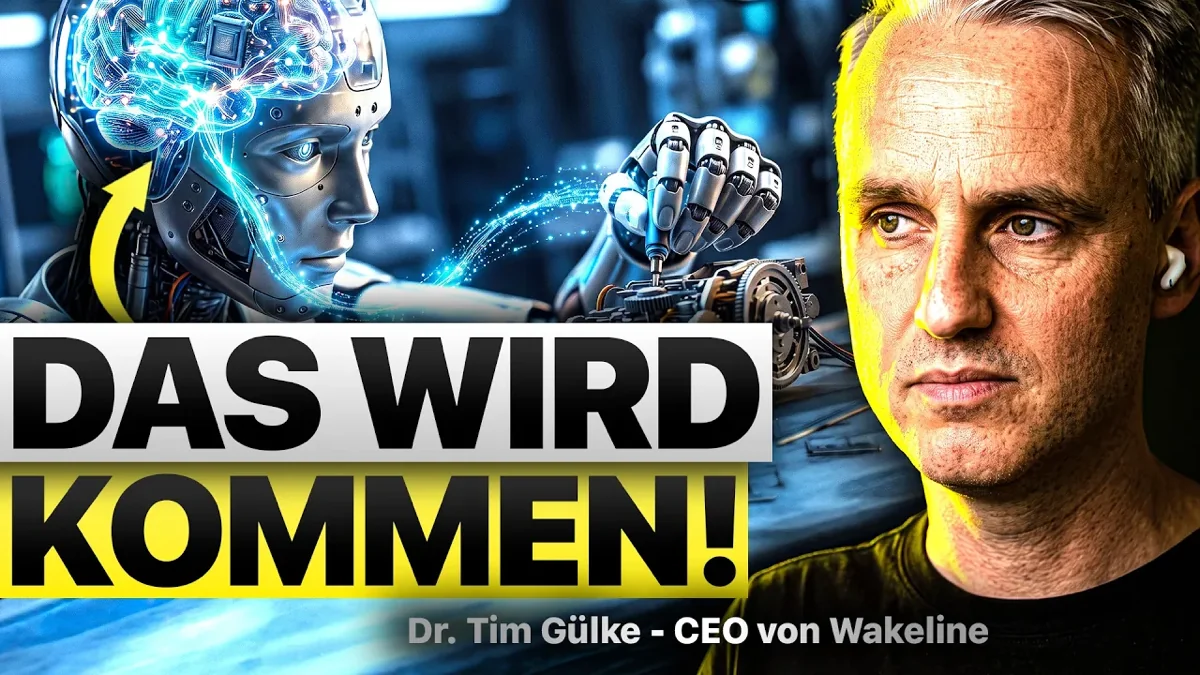
Continual Learning ist ein KI-Ansatz, bei dem Systeme im laufenden Betrieb weiterlernen. Das Düsseldorfer Startup Wakeline treibt diesen Ansatz radikal voran. Im Interview erklärt Gründer Dr. Tim Gülke, warum seine KI ganz ohne Deep Learning, Gewichte und Hyperscaler auskommt.
Für Unternehmen ist das Thema hochrelevant. Märkte, Maschinen und Lieferketten ändern sich schneller als jeder Trainingszyklus. Wir zeigen, wie das System funktioniert und wo es heute schon Geld verdient.
Warum eingefrorene KI-Modelle an Grenzen stoßen
Große Sprachmodelle sind laut Gülke eine Wette. Sie lernen aus riesigen Datenmengen allgemeine Strukturen. Danach werden sie eingefroren und in einen konkreten Anwendungsfall gebracht. Die Hoffnung: Das gelernte Wissen reicht, um das spezifische Problem zu lösen.
Genau hier liegt der Haken. Eine einzelne Maschine, eine lokale Wetterlage oder ein bestimmter Markt folgen oft eigenen Regeln. Dazu kommt eine sehr dynamische Welt. Gülke nennt die Lage in der Straße von Hormus und den Krieg in der Ukraine. Solche Ereignisse standen in keinem Trainingsdatensatz.
Ein eingefrorenes Modell arbeitet mit dem Stand seines Trainings. Ändert sich die Welt, trifft es schlechtere Entscheidungen. Mehr Daten und mehr Rechenleistung allein führen laut Gülke nicht zu besseren Entscheidungen. Diese Annahme hält er für die gefährlichste Fehleinschätzung der Branche.
So funktioniert Continual Learning bei Wakeline
Bei Wakeline gibt es keine Trennung zwischen Trainings- und Anwendungsphase. Das System ist stateful. Es läuft als kleine Instanz direkt in einer Umgebung mit und wird ständig aktualisiert. Es kann auf historischen Daten vorlernen, muss es aber nicht.
Das System bekommt einen Datenstrom und beginnt zu beobachten. Es stellt Hypothesen über die geltenden Regeln auf, testet sie und verwirft sie wieder. Dann handelt es, prüft die Folgen und passt sein Verhalten an. Gülke vergleicht das mit kleinen Lebewesen. Eine Ameise hat kein GPU-Rechenzentrum und kommt trotzdem in fremder Umgebung zurecht.
Technisch verzichtet Wakeline auf Backpropagation und Gradientenabstieg. Der Ansatz stammt eher aus der Signalverarbeitung. Einzelne Einheiten beobachten je einen Eingangskanal und lernen autonom. Manche lernen schnell, andere langsam. Anschließend koordinieren sie sich zu einem Gesamtbild der Umwelt.
Neues Wissen landet in einem separaten, mitwachsenden Speicher. Bestehende Gewichte muss das System deshalb nie überschreiben. Deep-Learning-Modelle verändern beim Nachlernen dagegen immer den gesamten Datenraum. Wer tiefer in die Grundlagen einsteigen will, findet in unserem Beitrag zu neuromorpher KI einen verwandten Ansatz.
Strommarkt als Benchmark: Schlechtere Prognose, mehr Gewinn
Wakeline arbeitet bereits mit Partnern aus Medizin und Industrie. In der Medizin geht es um neurodegenerative Krankheiten. Gehirnströme sind sehr individuell, das System muss am einzelnen Patienten lernen. In der Industrie optimiert es einzelne Maschinen und ganze Fabriken.
Öffentlich zeigt das Team seine Technik am Strommarkt. Die Daten sind frei verfügbar, Trading lässt sich simulieren. Ethikanträge oder lange Partnerprojekte entfallen. Zudem ändert sich der Markt rasant durch PV-Anlagen, Wallboxen, E-Autos und Smart Meter.
Über fünf Jahre lief das System gegen etablierte Prognose-Modelle. Das Ergebnis wirkt paradox. Beim reinen Prognosefehler lag Wakeline 20 bis 25 Prozent schlechter als der stärkste Konkurrent. Trotzdem verdiente das System mehr Geld.
Die Erklärung liegt im Aufbau. Ein Continuous Perception Layer bildet die Realität ab. Ein Executive Layer entscheidet auf dieser Basis, wie gehandelt wird. Beim Single Day Ahead Coupling zählt vor allem die Form der Preiskurve. Wer die Spitze trifft, verkauft zum richtigen Zeitpunkt, auch wenn der absolute Preis danebenliegt.
Kontinuierliches Lernen ohne Hyperscaler
Wakeline hat 2,1 Millionen Euro eingesammelt, angeführt von einem Fonds aus Aachen. Ein Startup aus dem OpenAI-Umfeld sammelt für dasselbe Thema eine halbe Milliarde Dollar. Gülke sieht darin keinen Nachteil. Sein System braucht kaum Geld für Compute.
Gestartet hat er das Projekt als Hobby auf dem eigenen Laptop. Bis heute läuft die Infrastruktur beim europäischen Anbieter Hetzner. Große Cloud-Anbieter braucht das Team nicht. Für viele Fälle wären sie sogar ungeeignet.
Ein Gerät am Patienten verarbeitet hochsensible Daten im Millisekundenbereich. Ein API-Aufruf in die Cloud wäre zu langsam. Dasselbe gilt für Maschinensteuerung und kritische Infrastruktur. Wir sehen bei unseren Kunden denselben Bedarf: Edge- und On-Device-KI wird zur Pflicht, sobald Daten sensibel oder zeitkritisch sind.
Auditierbarkeit und AI Act
Der AI Act verlangt von lernenden Systemen, ihre Veränderungen vorab zu dokumentieren. Bei einem System, das sich alle 15 Minuten aktualisiert, klingt das schwierig. Gülke sieht hier einen Vorteil seiner Architektur.
Deep-Learning-Modelle bestehen aus riesigen Matrizen voller Gewichte und Schwellwerte. Das Fehlen bestimmter Verhaltensweisen lässt sich dort nur aufwendig beweisen. Gülke kennt das Problem aus der Automobil-Branche. Bei der DARPA Urban Challenge 2007 fuhr sein Team einen VW Passat autonom durch die Stadt. Deep Learning spielte dabei noch keine Rolle.
Wakeline protokolliert jede Entscheidung. Im Log stehen Eingangsdaten, Vorhersage, Entscheidung und aktive Parameter. Das Team kann sogar simulieren, wie das System in einer anderen Lage entschieden hätte. Für Unternehmen in regulierten Branchen ist das ein starkes Argument.
Fazit: Continual Learning als nächste S-Kurve
Gülke würdigt die Ergebnisse großer Sprachmodelle ausdrücklich. Er nutzt sie selbst jeden Tag. Wirtschaftlich hält er den Ausbau gigantischer Rechenzentren aber nicht für dauerhaft tragfähig. Das menschliche Gehirn kommt mit 20 Watt aus. Transformer-Modelle erreichen diese Effizienz aus seiner Sicht so bald nicht. Unser Beitrag zum KI-Energieproblem ordnet diese Lücke ein.
Die nächste S-Kurve sieht Gülke in individuellen, adaptiven Lösungen direkt am Gerät und am Menschen. Continual Learning ohne Hyperscaler ist dafür ein vielversprechender Baustein. Für Europa könnte darin eine echte Chance liegen, vorne mitzuspielen. Unternehmen sollten diese Entwicklung früh beobachten und erste Pilotfälle prüfen.
Häufige Fragen
Was ist Continual Learning?
Continual Learning beschreibt KI-Systeme, die im laufenden Betrieb weiterlernen. Klassische Modelle werden einmal trainiert und dann eingefroren. Sie arbeiten danach mit dem Wissensstand ihres Trainings. Ein kontinuierlich lernendes System passt sich dagegen an neue Daten an. Das Düsseldorfer Startup Wakeline setzt dafür auf ein eigenes Verfahren ohne Deep Learning. Das System beobachtet Datenströme, stellt Hypothesen auf und verwirft sie wieder. Für Unternehmen mit schnell wechselnden Bedingungen ist das ein großer Hebel.
Wie lernt die KI von Wakeline ohne Gewichte?
Wakeline nutzt weder Backpropagation noch Gradientenabstieg. Das System stammt eher aus der Signalverarbeitung. Einzelne Einheiten beobachten je einen Eingangskanal und lernen autonom, wie er sich verhält. Danach koordinieren sie sich zu einem Gesamtbild der Umwelt. Neues Wissen landet in einem separaten Speicher. Dadurch muss das System keine bestehenden Gewichte überschreiben. Details hält das Team wegen laufender Patentanträge noch zurück.
Warum testet Wakeline seine KI am Strommarkt?
Am Strommarkt sind die Daten öffentlich einsehbar. Wakeline kann dort Trading simulieren und sich direkt gegen etablierte Verfahren benchmarken. Ethikanträge oder lange Abstimmungen mit Partnern entfallen. Zudem ändert sich der Markt laufend durch PV-Anlagen, E-Autos und geopolitische Krisen. Genau diese Dynamik zeigt, wie schnell sich ein lernendes System anpasst. Im Fünf-Jahres-Test erzielte es höhere Gewinne als die Konkurrenz.
Ist eine kontinuierlich lernende KI mit dem AI Act vereinbar?
Der AI Act verlangt von lernenden Systemen, ihre Veränderungen vorab zu dokumentieren. Laut Dr. Tim Gülke ist sein System jederzeit auditierbar. Jede Entscheidung lässt sich im Log nachvollziehen: Eingangsdaten, Vorhersage, Entscheidung und aktive Parameter. Zusätzlich kann das Team simulieren, wie das System in anderen Situationen entschieden hätte. Für kritische Infrastruktur ist diese Transparenz ein klarer Vorteil gegenüber Deep-Learning-Modellen.